Meine Bild-Pipeline mit InvokeAI – und wo sie an 16 GB VRAM scheitert
Wie ich mit InvokeAI und Krea 2 Turbo eine lokale Pipeline für Blog-Titelbilder gebaut habe: vom Prompt-Rezept über die API bis zum Skript, plus die Grenzen einer 16-GB-AMD-Karte – HIP-OOM, getiltes VAE-Decoding und ein Kaltstart von zehn Minuten.
Die Titelbilder dieses Blogs entstehen lokal, auf meiner eigenen Grafikkarte, ohne Cloud-Dienst. Dahinter steckt eine kleine Pipeline aus InvokeAI, dem Modell Krea 2 Turbo und einem Skript, das aus einem Satz Szene ein fertiges WebP macht. Das Ergebnis gefällt mir. Der Weg dorthin bestand aber zu einem guten Teil aus Speichergrenzen, und die sind der lehrreichere Teil.
Das System
- AMD-Karte der RX-6800-Klasse (gfx1030) mit 16 GB VRAM
- InvokeAI als Server, bedient über seine HTTP-API
- Krea 2 Turbo als quantisiertes GGUF (Q4_K_M): ein Transformer mit rund 12 Milliarden Parametern, dazu ein Qwen3-VL-Encoder als Text-Encoder
- Modelle liegen auf einer externen Platte, nicht auf der Systempartition
Das Modell ist für diese Karte nicht gebaut, sondern knapp hineingequetscht. Das prägt jede Einstellung.
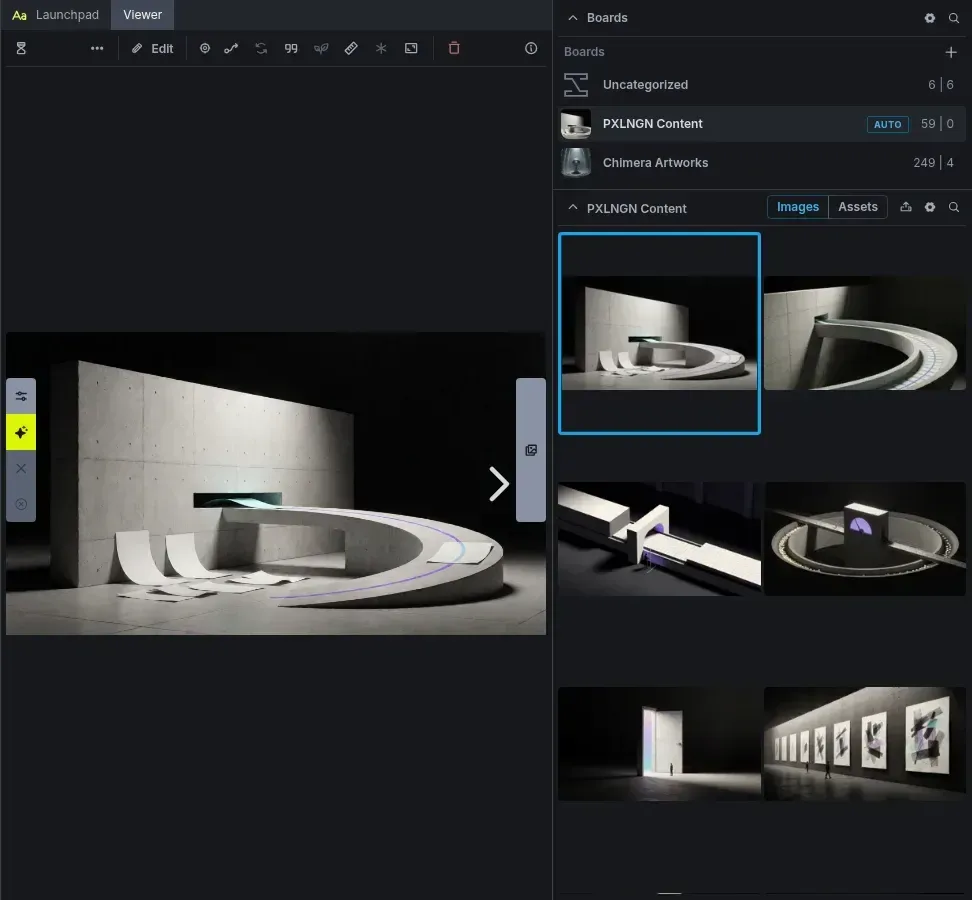
Die Pipeline in vier Schritten
- Szene schreiben: pro Post ein konkretes Motiv aus dem Thema, auf Englisch.
- Stil anhängen: ein fester Stil-Satz, der für alle Bilder gleich bleibt.
- Generieren: das Skript lädt den Workflow-Graphen aus einem früheren Output-PNG (InvokeAI legt ihn dort als Metadaten ab), tauscht Prompt und Seed aus und stellt den Auftrag per API in die Queue.
- Ablegen: das Ergebnis wird als WebP in den Blog-Ordner geschrieben, im Frontmatter kommt
imageAi: truedazu, damit das Bild als KI-Bild gekennzeichnet wird.
Der Aufruf ist bewusst klein:
python3 scripts/blog-image.py <post-key> "<Szene>" --seed 11Der Trick mit dem Graphen aus dem PNG spart mir, den Workflow selbst nachzubauen: Was in der Oberfläche einmal funktioniert hat, ist die Vorlage.
Wie sich das Rezept verändert hat
Am Anfang standen Style-Presets (Blueprint, Dark-Cyan-HUD). Sie lieferten austauschbare Icons, die zu jedem Thema passten und deshalb zu keinem. Danach kam eine Phase mit Hard-Surface-Maschinen, geborgt aus einem Spieleprojekt: Das sah gut aus, war aber ein Stil, der fast nur zu technischen Themen passte.
Zuletzt habe ich das Modell so benutzt, wie es trainiert ist: eine Szene aus dem Thema, dazu ein kurzer, fester Stil-Satz. Keine Preset-Kette, keine Negativ-Listen. Was ich dabei gelernt habe:
- Wichtigstes zuerst: Motiv und Form in den ersten Satz, Stil ans Ende.
- Kein Negative Prompt: Turbo läuft mit CFG 1, dabei bleibt ein Negative Prompt wirkungslos. Ausschlüsse funktionieren nur, wenn man sie positiv beschreibt.
- Text im Bild lässt sich schwer verbieten: Selbst „no text“ hilft bei Dokumenten nicht immer, dann kritzelt das Modell Pseudo-Schrift. Besser ist, die Blätter als „abstrakte Striche, keine Buchstaben“ zu beschreiben.
- Farbige Materialien brechen die Palette: Ein rostiger Kran fiel sofort aus dem Rahmen, ein grauer nicht.
- Mehrdeutigkeit lohnt zwei Seeds: Ich würfle zwei Varianten und wähle am Kontaktbogen.
Wo 16 GB nicht reichen
Jetzt zum eigentlichen Thema. Ein 12-Milliarden-Modell plus Encoder plus Bild-Decoder auf 16 GB: Das geht, aber nur mit Maßnahmen.
1. Das Bildformat ist hart begrenzt. Bei 1024 × 576 läuft alles durch, bei 1280 × 720 kommt ein HIP-OOM, also die AMD-Variante des Out-of-Memory-Fehlers. Die Titelbilder sind deshalb 1024 × 576. Für einen Blog ist das genug, für größere Ausgaben müsste ich hochskalieren.
2. Zu wenig Arbeitsspeicher-Reserve. InvokeAI lässt standardmäßig etwa 3 GB VRAM als Arbeitsreserve frei. Mit Krea 2 reichte das nicht, der Lauf brach mit OOM ab. Erst device_working_mem_gb: 5 hat das gelöst. Ein Teil des VRAMs gehört also nicht dem Modell, sondern dem Rechnen.
3. Der Decoder will auf einmal viel. Beim Dekodieren der Latents zum Bild verlangte ein SDXL-Lauf rund 9 GB am Stück. Die Lösung heißt getiltes Decoding: Das Bild wird in Kacheln dekodiert, force_tiled_decode: true. Es kostet etwas Zeit und spart den Spitzenverbrauch.
4. Ein Kernel-Benchmark hängt die Karte. Beim VAE-Decode des FLUX.2-Modells blieb die Karte beim Kernel-Tuning von MIOpen hängen. Die Umgebungsvariable MIOPEN_FIND_MODE=FAST überspringt den Benchmark und stand seitdem im Start-Skript.
5. Der Kaltstart ist lang. Transformer und Encoder müssen von der Platte in den Speicher. Beim ersten Bild nach dem Serverstart dauert das bei mir acht bis zehn Minuten, allein der Encoder braucht gut sieben. Mit max_cache_ram_gb: 18 bleiben beide Modelle im RAM, damit der nächste Lauf nicht wieder von der Platte lädt. Danach braucht ein Bild etwa anderthalb bis zwei Minuten.
Die Konfiguration, die das alles zusammenhält, ist kurz:
force_tiled_decode: true # Decoder in Kacheln, kein 9-GB-Spitzenbedarf
device_working_mem_gb: 5 # mehr Arbeitsreserve als der Standard von 3 GB
max_cache_ram_gb: 18 # Modelle im RAM halten, kein Kaltstart pro Bild
Was das für die Pipeline bedeutet
Die Pipeline ist kein Interaktivwerkzeug, sondern ein Batch-Werkzeug. Wer ein einzelnes Bild will, wartet beim ersten Mal zehn Minuten. Wer zwanzig will, startet den Server einmal und lässt die Queue durchlaufen: Mein Durchgang über alle Blog-Titelbilder hat nur etwa eine halbe Stunde gedauert, weil der Kaltstart nur einmal anfiel.
Der Punkt dahinter ist derselbe wie bei lokalen Sprachmodellen: Auf kleiner Hardware entscheidet nicht die Modellqualität, sondern wie sauber man die Engpässe kennt. Wer weiß, wo der Speicher hingeht, kann ihn verteilen. Wer es nicht weiß, sieht nur eine Fehlermeldung und wechselt das Modell.
Was noch offen ist
- Höhere Auflösungen gehen nur über Hochskalieren, das ist noch nicht in der Pipeline.
- Der Kaltstart ist ein Komfortproblem. Ein dauerhaft laufender Dienst würde ihn verstecken, kostet dann aber dauerhaft RAM.
- Das Frontmatter setze ich noch von Hand, das Skript gibt nur einen Hinweis aus.