Du brauchst kein teures Modell
Eine Notiz über Spezifikation statt Modellgröße: warum Task-Präzision und ein Verifikations-Loop mehr Reliability bringen als das nächste Frontier-Modell – und warum das direkt in Token und Watt messbar ist.
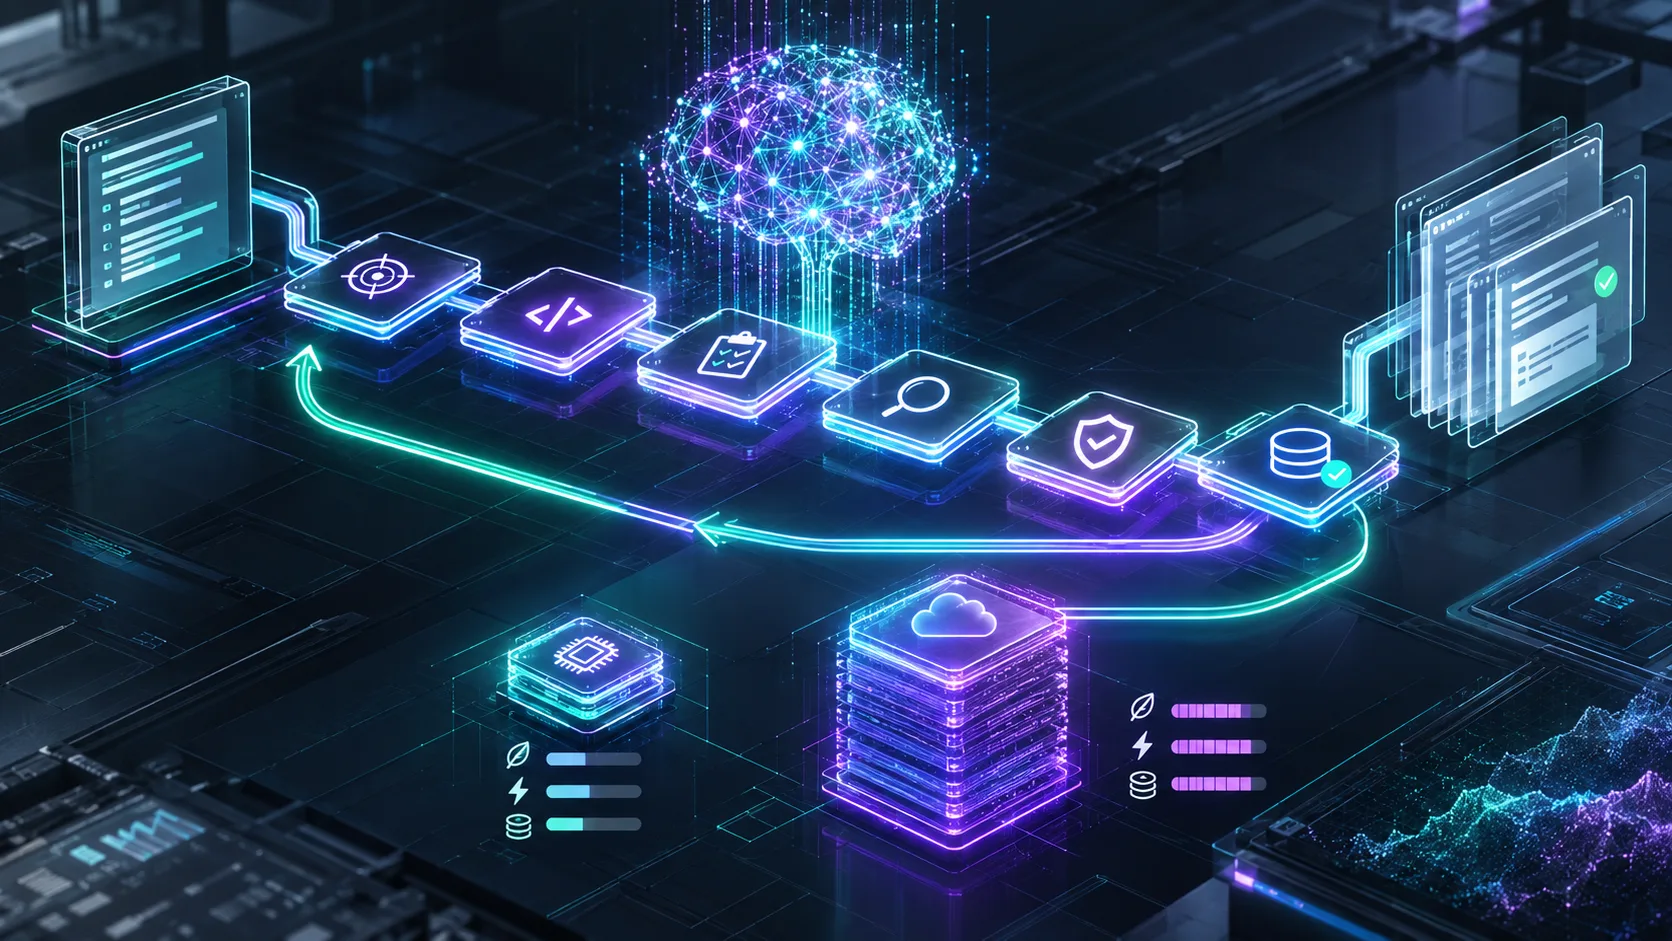
Ich ertappe mich selbst dabei, immer wieder: ein neues Modell kommt raus, ein paar Punkte höher auf irgendeiner Benchmark, und der erste Reflex ist, den Task-Router umzubiegen, den Default hochzuziehen. Meistens ändert das nichts am Ergebnis. Nicht weil die Modelle nicht besser würden, sondern weil das, was bei mir schiefging, selten ein Modellproblem war – es war ein Spezifikationsproblem, das ich der Kapazität des größeren Modells überlassen habe, anstatt es selbst zu lösen.
Wir behandeln LLMs zu oft wie ein Orakel: Frage rein, hoffen, dass die Antwort trägt, und wenn nicht, eskalieren auf das nächstgrößere Modell statt auf die eigene Spezifikation zu schauen. Ein LLM ist aber kein Orakel, sondern ein Executor. Es arbeitet exakt so gut, wie der Task, die Constraints und die Erfolgskriterien definiert sind, die man ihm mitgibt.
Der Unterschied ist keine Nuance
Wer ein Modell wie eine Intelligenz behandelt, delegiert Verantwortung an etwas, das kein Urteilsvermögen hat – nur eine Verteilung über plausible Fortsetzungen. Man bekommt eine Antwort, kann sie kaum verifizieren und hofft, dass Wahrscheinlichkeit genug war.
Wer es wie einen Executor behandelt, behält die Verantwortung selbst. Die Aufgabe, den Rahmen, die Abbruch- und Erfolgskriterien definiert man vorher – und bekommt danach etwas, das man tatsächlich gegen etwas prüfen kann, statt es nur zu lesen und zu hoffen.
Zuverlässigkeit skaliert bei einem klar spezifizierten Task deutlich schneller mit der Präzision des Inputs als mit Modellgröße. Ein 8B-Modell mit sauberer Spezifikation schlägt in der Praxis oft ein Frontier-Modell mit vagem Prompt – weil letzteres seine zusätzliche Kapazität dafür verbrennt, die Lücken in der Aufgabenstellung zu erraten, statt die Aufgabe selbst zu lösen.
Warum sich das schwer anfühlt
Ehrlich betrachtet ist daran nichts neu. Loop Engineering, Context Engineering, Agent Swarms – das sind die aktuellen Schlagworte für dieselbe Erkenntnis, verpackt in neue Tooling-Schichten. Nächstes Jahr heißen sie anders. Wer der Technik hinterherläuft, jagt ein bewegliches Ziel und lernt dabei nie, was eigentlich dahintersteckt: dass Kontext- und Prompt-Design kein Ornament sind, sondern die eigentliche Schnittstelle zur Fähigkeit des Modells.
Der eigentlich unbequeme Schritt ist ein anderer: nicht fragen „welches Modell ist gerade am leistungsfähigsten”, sondern „wie eng lässt sich der Task spezifizieren, bis ein kleines Modell reicht”. Das ist unbequem, weil die Arbeit dann bei mir liegt, nicht beim Provider. Ein größeres Kontingent zu buchen ist billiger in Aufwand, aber teurer in allem, was danach kommt – Debugging, Token, Latenz.
Präzision hat einen Preis – und der ist Strom
Was an dem Gedanken hängen bleibt: Jede Unschärfe im Input rechnet sich direkt in Token um. Ein unterspezifizierter Task zwingt das Modell in längere Reasoning-Chains, mehr Retries, mehr verworfene Zwischenschritte – es muss Mehrdeutigkeit durch zusätzliche Inferenz kompensieren, die ich ihm mit einer schärferen Spezifikation hätte ersparen können. Mehr Token heißt mehr Rechenzeit auf realer GPU-Hardware, heißt mehr Kilowattstunden.
„Mach mal was Schönes” ist nicht deshalb teuer, weil das Modell teuer ist, sondern weil die Unterspezifikation teuer ist – sie verlagert Inferenzkosten vom Prompt in den Sampling-Prozess. Ein eng gefasster Task mit klaren Erfolgskriterien ist dagegen fast langweilig effizient: kein Suchraum, den das Modell erst eingrenzen muss.
Wer konsequent so eng spezifiziert, merkt: Oft reichen kleinere, sogar lokal gehostete Modelle. Kein Cloud-Roundtrip, keine Abhängigkeit von einem Provider – und ein Bruchteil des Energieverbrauchs, weil nicht jeder Task durch ein fremdes Rechenzentrum geschleust wird, nur um eine Lücke in der eigenen Spezifikation aufzufangen.
Präzision ist nicht die ganze Geschichte
Trotzdem wäre es zu einfach, alles auf den Input zu reduzieren. Ein einzelner Forward Pass durch einen einzelnen Prompt bleibt stochastisch – auch bei perfekter Spezifikation bleibt eine Fehlerrate, die kein Prompt-Tuning auf null bringt. Die andere Hälfte der Qualität kommt nicht aus noch schärferer Formulierung, sondern aus dem Prozess, der um den einzelnen Call herum gebaut wird: planen, gegen Tests verifizieren, aus einem frischen Kontext gegenlesen (damit der Reviewer nicht dieselben blinden Flecken hat wie der Autor), nachbessern, das Ergebnis persistieren, damit derselbe Fehler beim nächsten Lauf nicht erneut auftritt.
Das ist strukturell derselbe Trick wie bei einem Error Correcting Code: nicht einmal senden und auf ein sauberes Signal hoffen, sondern Redundanz und Prüfschritte einbauen, die einen Fehler auffangen, bevor er am anderen Ende ankommt. Auf Agenten-Workflows übertragen heißt das: plan → implement → test → review-aus-frischem-Kontext → verify → persist, als feste Pipeline, statt bei jedem Call neu zu hoffen, dass der eine Prompt schon reicht. Der Executor bleibt derselbe Executor mit derselben Fehlerrate pro Call. Was sich ändert, ist, dass er nicht mehr in einem einzigen ungesicherten Schritt läuft, sondern in einer Schleife, die genau diese Fehlerrate systematisch herunterdrückt.
Präzise Spezifikation und guter Verifikations-Loop sind also kein Widerspruch, sondern zwei unabhängige Stellschrauben derselben Verantwortung: Die Spezifikation bestimmt, was der Executor pro Call tun soll. Der Loop bestimmt, wie viele fehlerhafte Calls ich mir leisten kann, bevor das Ergebnis in Produktion geht.
Ein Schritt zurück
Vielleicht ist das die eigentliche Erinnerung, die ich mir selbst schreibe: Die Intelligenz sollte nicht im Modell liegen, sondern in der Spezifikation und im Loop drumherum. Das Modell ist der Executor. Wie eng ich die Aufgabe fasse und wie robust die Schleife ist, die sein Ergebnis prüft, entscheidet, wie viel Modell ich dafür überhaupt brauche.
Die Modell-Releases werden weiterziehen, und ich werde vermutlich trotzdem jedes neue Modell anschauen, aus Neugier und weil es zum Job gehört. Aber die Frage, die zählt, bleibt dieselbe: nicht „was kann das Modell”, sondern „wie eng habe ich den Task gefasst, und was fängt seine Fehler auf”. Manchmal ist der klügere Schritt nicht, den Kontext-Bereich hochzuskalieren, sondern kurz zurückzutreten und die eigene Spezifikation noch einmal schärfer zu fassen.