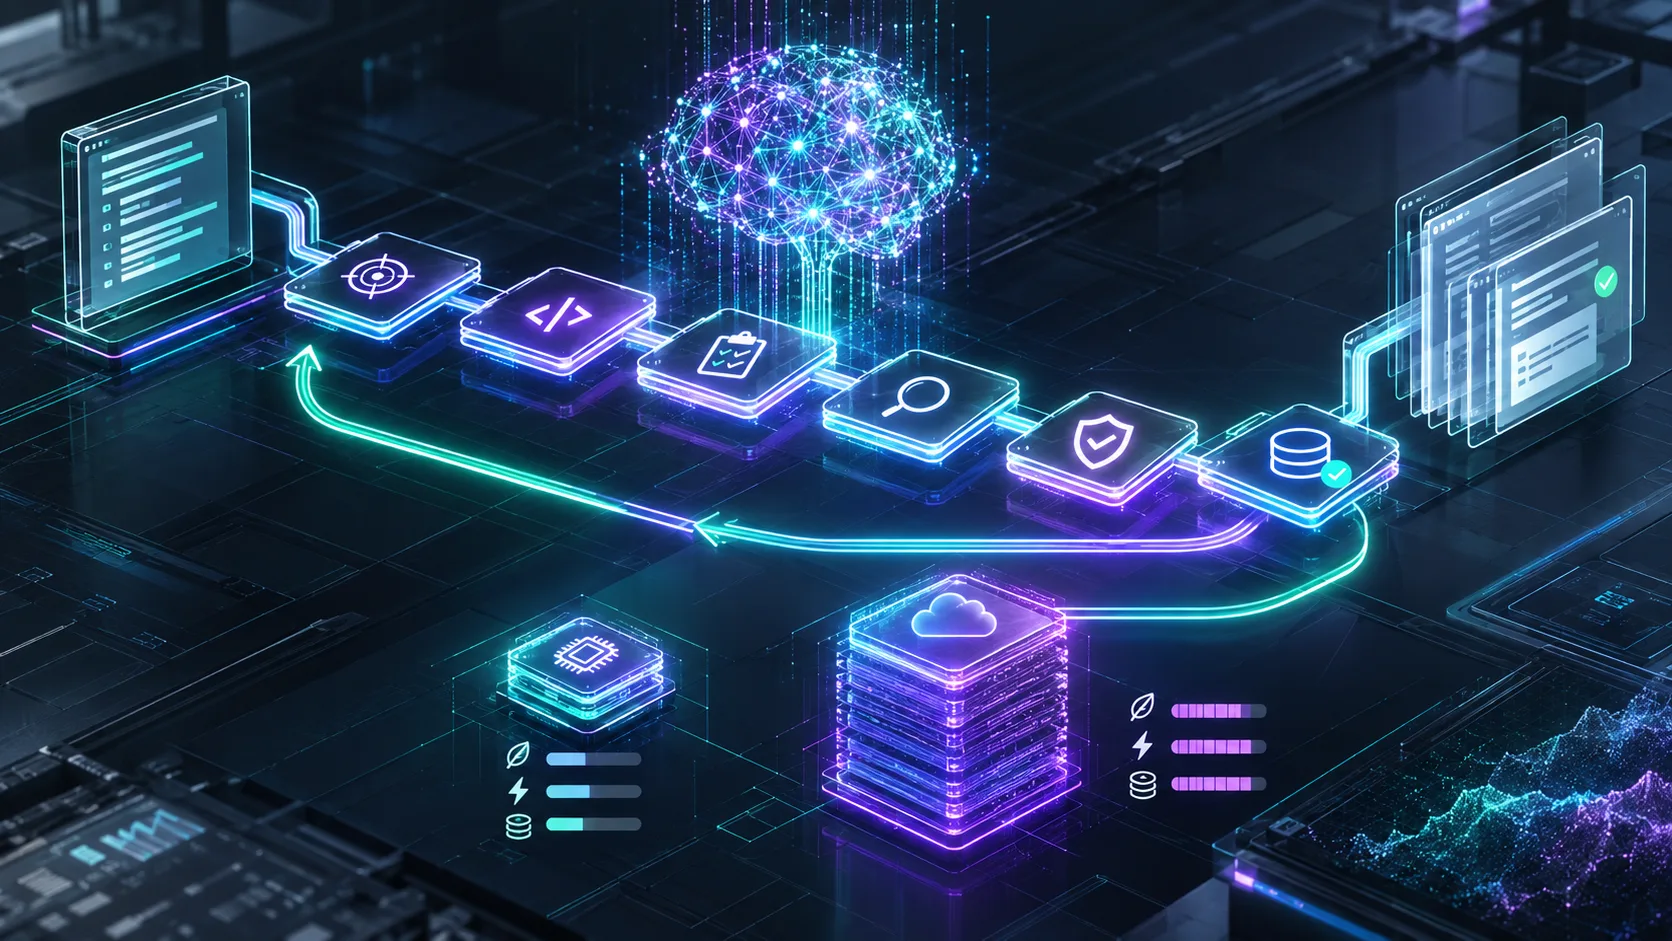
Comment j’ai construit avec InvokeAI et Krea 2 Turbo un pipeline local pour les images de couverture du blog : de la recette de prompt à l’API puis au script, plus les limites d’une carte AMD de 16 Go – HIP OOM, décodage VAE par tuiles et un démarrage à froid de dix minutes.
Claude Code liefert Telemetrie, aber keine Antwort auf die Frage, wo mein Verbrauch hingeht. Also exportiere ich sie lokal, lasse sie von Claude selbst auswerten und messe, ob die Maßnahmen wirken – ein Feedback-Loop in einer einzigen Python-Datei ohne Abhängigkeiten.
Schema erzwingen, Ausgabe validieren, mit Fehlerliste neu versuchen, reparieren statt abbrechen – wie die Jobschleuse ein kleines lokales Modell zuverlässig genug macht. Konkreter Code statt Theorie.
Une note sur la spécification plutôt que la taille du modèle : pourquoi la précision de la tâche et une boucle de vérification apportent plus de fiabilité que le prochain modèle de pointe – et pourquoi cela se mesure directement en tokens et en watts.