Warum ich einen Token-Monitor gebaut habe
Claude Code liefert Telemetrie, aber keine Antwort auf die Frage, wo mein Verbrauch hingeht. Also exportiere ich sie lokal, lasse sie von Claude selbst auswerten und messe, ob die Maßnahmen wirken – ein Feedback-Loop in einer einzigen Python-Datei ohne Abhängigkeiten.
Wer täglich mit Claude Code arbeitet, optimiert Verbrauch meistens nach Gefühl: „Das war bestimmt teuer.“ „Opus nehme ich nur, wenn es sein muss.“ „Die Session war irgendwie lang.“ Das Gefühl liegt oft daneben, und selbst wenn nicht, sagt es mir nicht, welche Gewohnheit das Kontingent frisst. Genau deshalb habe ich den Token-Monitor gebaut. Er beantwortet eine einzige Frage: Wo bleiben meine Tokens, und welche Änderung bringt wirklich etwas?
Die Idee: Telemetrie exportieren und zurückfüttern
Claude Code kann seine eigene Telemetrie als OpenTelemetry-Events senden: jeder API-Request mit Modell, Input, Output, Cache-Read, Cache-Create und Kosten, jeder Prompt, jeder Tool-Aufruf mit Erfolg oder Fehler. Die Daten sind also längst da. Es fehlte nur der Ort, an dem sie landen und ausgewertet werden.
Der Monitor ist dieser Ort, und er schließt einen Kreis:
- Erfassen: Claude Code sendet die Events per OTLP/HTTP-JSON an den Monitor auf
127.0.0.1. - Speichern: Alles landet in einer SQLite-Datei.
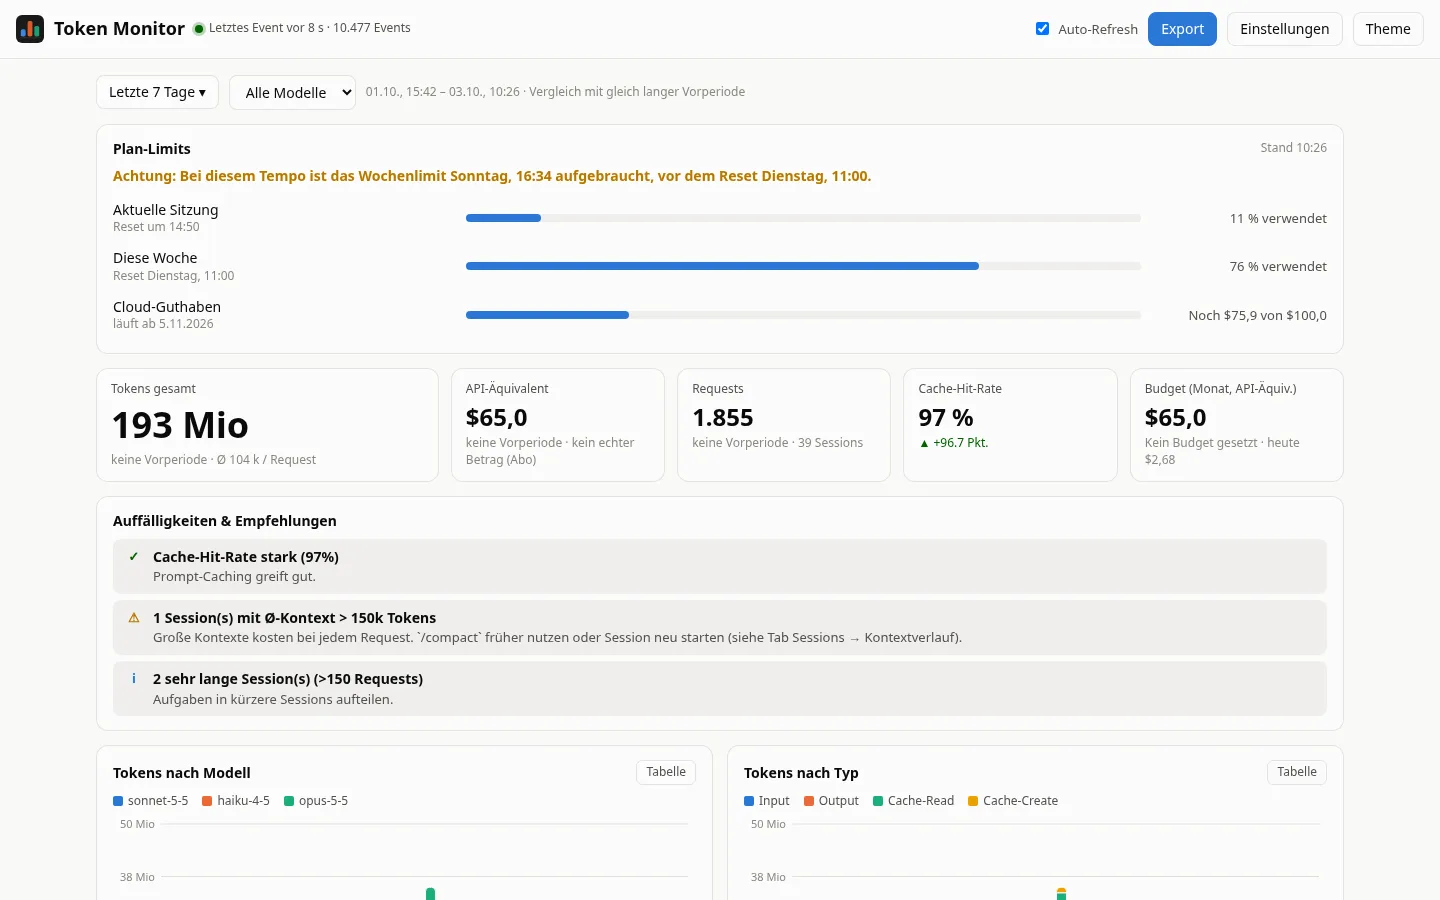
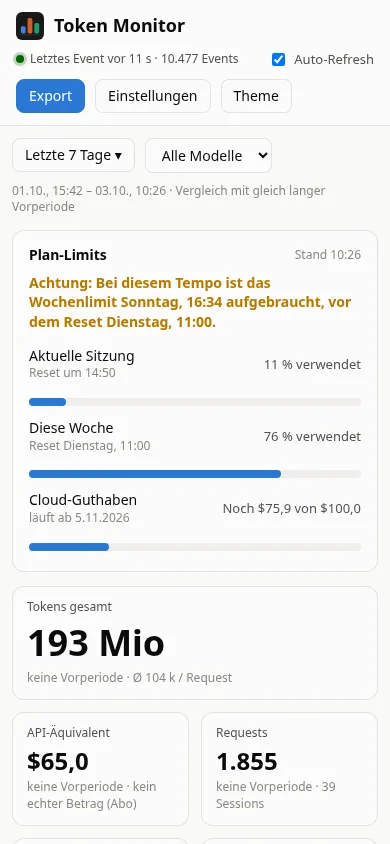
- Auswerten: Ein Dashboard zeigt Kosten, Tokens, Cache-Hit-Rate, Sessions, Prompts und Tools.
- Exportieren: Ein Klick erzeugt Markdown, das ich direkt in Claude einfüge.
- Optimieren: Claude liest seine eigene Nutzung und schlägt Maßnahmen vor.
- Messen: Der Vorperioden-Vergleich zeigt, ob die Maßnahme gewirkt hat.
Der entscheidende Schritt ist der vierte. Ein Dashboard allein ist Deko, solange ich selbst die Schlüsse ziehen muss. Der Export ist so gebaut, dass er die Aufgabe gleich mitliefert:
## Aufgabe

Analysiere die Daten und gib mir konkrete Maßnahmen, um Token-Verbrauch und
Kosten zu senken (Modellwahl, Cache-Nutzung, Kontextgröße/`/compact`, teure
Prompts, Tool-Muster, Subagents). Priorisiere nach Einsparpotenzial, max. 7
Punkte, kurz.
Danach folgen Gesamtwerte, automatisch erkannte Auffälligkeiten, eine Tabelle pro Modell, der Verlauf, die teuersten Sessions und Prompts sowie die Tool-Statistik. Das ist Context Engineering im Kleinen: ein kompakter, strukturierter Kontext mit klarer Aufgabe statt „hier sind 40.000 Zeilen Log, schau mal“.
Anbinden in einer Minute
Der Monitor ist reines Python (Standardbibliothek), kein Build, keine Pakete. In der settings.json von Claude Code reichen fünf Umgebungsvariablen:
{
  "env": {
    "CLAUDE_CODE_ENABLE_TELEMETRY": "1",
    "OTEL_LOGS_EXPORTER": "otlp",
    "OTEL_EXPORTER_OTLP_PROTOCOL": "http/json",
    "OTEL_EXPORTER_OTLP_ENDPOINT": "http://127.0.0.1:4318",
    "OTEL_LOG_USER_PROMPTS": "1"
  }
}
Die letzte Variable ist optional und speichert Prompt-Texte im Klartext. Dazu gleich mehr.
Regeln statt Bauchgefühl
Im Monitor stecken einfache, einzeln nachvollziehbare Regeln, die auf den Rohdaten laufen. Keine Magie, nur Schwellwerte, die ich aus der Praxis kenne:
- Cache-Hit-Rate unter 70 %: Kontext wird ständig neu berechnet. Typische Ursachen sind Pausen über fünf Minuten, wechselnde
CLAUDE.mdoder neue Sessions für jede Kleinigkeit. - Viele Cache-Writes im Verhältnis zu Cache-Reads: Der Cache wird oft neu aufgebaut.
- Opus mit mehr als 40 % der Kosten: Reicht für diese Aufgaben Sonnet, und könnten Subagents auf Haiku laufen?
- Ø-Kontext über 150.000 Tokens: Jeder Request trägt den ganzen Kontext mit. Früher
/compactnutzen oder die Session neu starten. - Top-3-Prompts mit über 30 % der Kosten: Einzelne teure Prompts dominieren, vielleicht lassen sie sich splitten oder präzisieren.
- Tools mit über 15 % Fehlerrate: Jede Wiederholung verbrennt Tokens.
Das ist dasselbe Prinzip wie im Verifikations-Loop: Die Prüfung gibt eine Liste von Befunden in Klartext zurück, keinen Wahrheitswert. Dieselbe Liste ist Anzeige im Dashboard, Teil des Exports und Material für Claude.
Warum lokal
Telemetrie über meine eigene Arbeit enthält zwangsläufig Sensibles: Projektnamen, Prompts, Dateipfade. Deshalb gelten ein paar harte Grenzen:
- Der Server bindet ausschließlich an
127.0.0.1. - Es gibt keinen Cloud-Dienst und kein Konto, nur eine lokale SQLite-Datei, die nicht ins Repository gehört.
- Prompt-Texte werden nur gespeichert, wenn ich
OTEL_LOG_USER_PROMPTSausdrücklich setze, und der Export blendet sie standardmäßig aus. - Eine Aufbewahrungsfrist und Löschfunktionen räumen alte Daten auf.
- Für die Handy-Ansicht (PWA) läuft der Zugriff nur über das eigene Tailnet, nie über einen öffentlichen Zugang.
Der Zusammenhang mit „Du brauchst kein teures Modell“
In „Du brauchst kein teures Modell“ steht die Behauptung, dass Spezifikation und ein Loop mehr bringen als das größere Modell und dass sich das direkt in Token messen lässt. Der Token-Monitor ist der Teil, der dieses „messen“ einlöst. Ohne Zahlen wäre es wieder nur eine Haltung.
Was ich noch nicht behaupte
Der Monitor ist frisch, die Datenbasis klein. Ich nenne deshalb hier bewusst keine Einsparquote. Eine Zahl nach wenigen Tagen wäre Zufall, kein Ergebnis. Der Plan ist schlicht: einige Wochen Daten sammeln, die Maßnahmen aus dem Export umsetzen und im Vorperioden-Vergleich nachsehen, was davon geblieben ist. Wenn dabei etwas Überraschendes herauskommt, schreibe ich es hier auf.